
Die meisten KI-Projekte scheitern nicht an einer falschen Modellarchitektur. Sie scheitern, weil die Trainingsdaten schlecht gelabelt wurden. Nach mehr als 10 Jahren und über 200 Projekten bei Silk Data sehen wir immer wieder dasselbe Muster. Teams investieren beträchtliche Budgets in die Auswahl des ausgefeiltesten Algorithmus. Gleichzeitig wird der Labeling-Schritt, der bestimmt, was das Modell tatsächlich lernt, wie eine Nebentätigkeit behandelt. Dieser Leitfaden erklärt, warum diese Reihenfolge falsch ist und was dagegen zu tun ist.
Die wichtigsten Erkenntnisse
| Punkt | Bedeutung für Ihr Projekt |
|---|---|
| Labels bestimmen das Modell | Das Modell weiß nur, was Ihre Labels aussagen. Falsche Labels = eine falsche Lektion, die bei jeder Inferenz wiederholt wird. |
| Datenvorbereitung macht 50–65 % der Arbeit aus | In unserer Projektökonomie entfallen auf die Modellierung 10–15 %. Die versteckten Kosten liegen im Labeling und der Datenbereinigung. |
| Qualität schlägt Quantität | Zwei Annotatoren mit entzerrten Labels können acht Annotatoren mit einfacher Mittelung entsprechen. Weniger, aber bessere Bewerter setzen sich durch. |
| Drift ist der stille Ausfallmodus | Definitionen verschieben sich über Monate. Ohne versionierte Spezifikation trainiert Ihr Modell auf der Richtlinie von gestern. |
| Labeling ist Governance, keine Datenerfassung | In Finanzwesen und Gesundheitswesen unter DSGVO oder EU AI Act muss jedes Label eine nachvollziehbare Herkunft aufweisen. |
Was Datenlabeling ist und wo es hineinpasst
Datenlabeling weist Rohdaten Tags oder Kategorien zu, damit ein überwachtes Modell ein Ziel zum Lernen hat. Spam oder kein Spam. Tumor oder kein Tumor. Betrügerisch oder legitim. Ohne Labels hat ein überwachtes Modell keinen Bezugspunkt.
Labeling und Annotation sind nicht dasselbe. Labeling weist einem Datenpunkt eine Kategorie zu. Annotation fügt strukturierte Metadaten hinzu – Bounding Boxes auf Bildern, Zeitstempel in Audiodateien, Entity-Spans in Texten. Beide dienen dem überwachten Lernen. Sie verursachen jedoch unterschiedliche Kosten und erfordern unterschiedliche Werkzeuge.
Einige Beispiele, die wir umgesetzt oder beratend begleitet haben:
- Klassifizierung von Online-Werbeereignissen zur Klick-Vorhersage bei starkem Klassenungleichgewicht mit 0,1–0,5 % CTR.
- Tagging von Prüfungsabgaben zum Training des Klassifikators in Plagiarix, unserem Anti-Plagiats-Produkt.
- Strukturierung von Lebensläufen in Kandidatenfelder für das KI-gestützte Lebenslauf-Screening.
- Clustering und Tagging von Nachrichtenartikeln für unsere Chrome-Erweiterung zur automatischen Nachrichtenanalyse.
Das Muster über diese Projekte hinweg ist stets dasselbe. Die Wahl zwischen CatBoost und einem anderen Gradient Booster entscheidet nur selten über das Ergebnis. Die Label-Definitionen sind ausschlaggebend. Hier verbirgt sich auch der größte Teil des Projektrisikos: Ein falscher Algorithmus zeigt sich in einem Testreport; eine falsche Label-Definition zeigt sich erst Monate später, nachdem das Modell in der Produktion selbstbewusst falsche Entscheidungen getroffen hat.
Wie die Labeling-Qualität die Modellgenauigkeit prägt
Die Labeling-Qualität ist messbar. Sie begrenzt unmittelbar, wie gut Ihr Modell abschneiden kann. Die erste zu verfolgende Kennzahl ist die Inter-Rater-Reliabilität – wie oft zwei Annotatoren demselben Datenpunkt dasselbe Label geben. Wenn sie nicht übereinstimmen, trainiert das Modell auf widersprüchlichen Signalen. Es lernt in diesen Fällen nichts Verwertbares.
Arbeiten zur Aggregation verrauschter Annotator-Labels, einschließlich dieser arXiv-Studie zum Annotator-Debiasing, weisen auf eine praktische Erkenntnis hin. Ein kleiner Pool sorgfältig entzerrter Annotatoren kann die Genauigkeit deutlich größerer Pools mit naiver Mehrheitswahl erreichen. Investitionen in bessere Richtlinien und Konfliktlösung zwischen Annotatoren übertreffen häufig Investitionen in mehr Bewerter.
So gehen wir in der Praxis vor:
- Führen Sie einen Piloten mit einer repräsentativen Stichprobe durch – in der Regel 200 bis 1000 Elemente.
- Berechnen Sie die Übereinstimmung mit Cohens Kappa oder Cronbachs Alpha, je nach Aufgabe.
- Listen Sie die Elemente auf, bei denen die Bewerter nicht übereinstimmen. Lesen Sie sie durch. Überarbeiten Sie die Richtlinie.
- Führen Sie den Piloten erneut durch. Vergleichen Sie die Übereinstimmung.
- Wenden Sie Debiasing (Random Effects Models, Dawid-Skene) erst an, nachdem sich die Richtlinien stabilisiert haben.
Die Abwägung ist eindeutig. Debiasing gewinnt Signal zurück, wenn Sie einige wenige Annotatoren pro Element haben. Es rettet Sie nicht, wenn die Richtlinien selbst fehlerhaft sind. Wir haben Teams gesehen, die eleganten Aggregationsmethoden auf einer fehlerhaften Spezifikation nachjagten. Das Ergebnis ist ein präzise konsistenter Unsinn.
Wie Yuliya Marazenko, die unsere KI-Implementierungsarbeit leitet, es formuliert: Der günstigste Weg, ein Modell zu verbessern, besteht in der Regel darin, die Labeling-Richtlinie neu zu schreiben, nicht das Modell neu zu trainieren. Wir haben diesen Schritt in den meisten Projekten wiederholt, bei denen ein Kunde frustriert von einem stagnierenden Modell zu uns kam.
Ein praktischer Anhaltspunkt zu den Kosten. Das Umschreiben einer Labeling-Richtlinie erfordert in der Regel eine Ingenieurwoche zuzüglich zwei bis vier Stunden eines Fachexperten. Das erneute Training eines stagnierenden Modells mit denselben schlechten Labels erfordert typischerweise ein bis zwei Ingenieurmonate und liefert am Ende dasselbe schwache Ergebnis. Wir haben diesen Vergleich so oft gezogen, dass er zur ersten Frage geworden ist, die wir stellen, wenn ein Kunde sagt: „Das Modell funktioniert nicht.“
Labels bei Skalierung konsistent halten
Drift ist der stille Ausfallmodus bei langfristiger Labeling-Arbeit. Richtlinien entwickeln sich weiter, Annotatoren wechseln, Grenzfälle häufen sich an. Ein vor sechs Monaten gelabelter Datensatz zur Betrugserkennung verwendet möglicherweise bereits eine andere Definition von „betrügerisch“ als Ihr Compliance-Team heute. Das Modell wird die alte Richtlinie weiter lernen, bis Sie neu labeln.
Die praktische Lösung besteht darin, die Labeling-Spezifikation wie Produktionscode zu behandeln: versioniert, geprüft und mit dem Datensatz-Snapshot verknüpft, den sie erzeugt hat. Kombinieren Sie sie mit zwei Prüfebenen – einem automatisierten Checker für offensichtliche Regelverstöße und einem menschlichen Prüfer für Grenzfälle, die die Spezifikation nicht antizipiert hat.
Was Sie gewinnen:
- Weniger Drift, da jeder Annotator gegen denselben versionierten Text arbeitet.
- Schnelleres Onboarding – neue Annotatoren lesen eine Spezifikation, anstatt implizites Wissen zu übernehmen.
- Ein Prüfpfad, der unter der DSGVO für personenbezogene Daten und unter dem EU AI Act für Hochrisikosysteme relevant ist.
- Grenzfälle werden frühzeitig erkannt, bevor sie in das Trainingsset gelangen.
Was Sie dafür bezahlen:
- Vorlaufzeit für das Schreiben der Spezifikation – in der Regel 1 bis 3 Wochen für eine nicht triviale Domäne.
- Eine Prüferrolle, die keine Labels direkt produziert, aber schlechte blockiert.
- Anfangs langsamerer Durchsatz, später schneller und stabiler.
Der Break-even liegt in der Regel zwei bis drei Monate nach Projektbeginn, abhängig von der Datensatzgröße. Danach zahlen Teams ohne versionierte Spezifikation dieselben Kosten für Nacharbeit und Audit-Vorbereitung, nur verteilt und schwerer erkennbar.
Wenn Sie einen Anbieter auswählen oder dies intern aufbauen, sollte das Team, das KI-Beratung und Machbarkeitsprüfungen durchführt, dasselbe Team sein, das die Spezifikation verantwortet. Die Trennung von Strategie und Labeling-Richtlinien ist der Ausgangspunkt für Drift.
Datenzentriert vs. modellzentriert: Wo investieren?
Der Wandel von modellzentrierter zu datenzentrierter KI ist kein Marketing. Er spiegelt sich bereits in unserer Projektökonomie wider. Bei einem typischen Aufbau entfallen etwa 10 % des Aufwands auf die Metrikdefinition. Die Datenvorbereitung nimmt 50–65 % ein. Auf die Modellierung entfallen 10–15 %. Auf das Deployment ebenfalls 10–15 %. Das Monitoring ist zeitlich offen. Die Labels befinden sich innerhalb des größten Anteils.

Beide Ansätze haben ihre Berechtigung. Der direkte Vergleich:
| Ansatz | Wann er sich durchsetzt | Wo er versagt | Governance-Aufwand |
|---|---|---|---|
| Modellzentriert | Benchmark-Aufgaben mit sauberen öffentlichen Daten; Probleme, bei denen die SOTA-Architektur die Kennzahl deutlich verbessert | Tatsächliche Geschäftsdaten mit Label-Rauschen, Drift oder seltenen Klassen | Niedrig |
| Datenzentriert | Die meisten Geschäftsprobleme: unausgewogene Klassen, regulierte Bereiche, sich entwickelnde Definitionen | Wenn die Daten schlichtweg nicht ausreichen – kein noch so umfangreiches Labeling behebt 0,1 % CTR bei 100.000 Datensätzen | Hoch |
Die datenzentrierte Sichtweise hat ihre Grenzen. Aus unserem Klick-Vorhersage-Projekt mit 0,1–0,5 % CTR: Wenn die positive Klasse so selten ist, benötigen Sie zehn Millionen Datensätze und mehr. Saubere Labels helfen, aber Resampling ersetzt keine Datenmenge. Ingenieurmäßiges Urteilsvermögen bleibt ausschlaggebend.
Die Regel, die wir intern anwenden: Wenn Ihr Problem mehr als einige hundert relevante Merkmale pro Datensatz und eine saubere Grundwahrheit aufweist, zahlt sich modellzentrierte Arbeit weiterhin aus. Wenn Ihr Problem fünfzig Merkmale, mehrdeutige Labels und einen Compliance-Beauftragten im Raum umfasst, zahlt sich datenzentrierte Arbeit vielfach aus. Die meisten Unternehmensprojekte fallen eindeutig in die zweite Kategorie.
Die Regulierung drängt in dieselbe Richtung. Der EU AI Act legt Data-Governance-Anforderungen für Hochrisiko-KI-Systeme fest, die auf dem EU-Markt in Verkehr gebracht werden, einschließlich der Dokumentation von Trainingsdaten und Labeling-Entscheidungen. Die DSGVO gilt überall dort, wo personenbezogene Daten im Datensatz vorhanden sind. FERPA schränkt Schülerdaten in EdTech in den USA ein. Nichts davon verlangt ein ausgefeilteres Modell. Alles davon verlangt Labels, die Sie verteidigen können.
Ein praxistaugliches Playbook für Datenlabeling
Das Playbook ist kurz. Die Disziplin, es zu befolgen, ist der schwierige Teil.
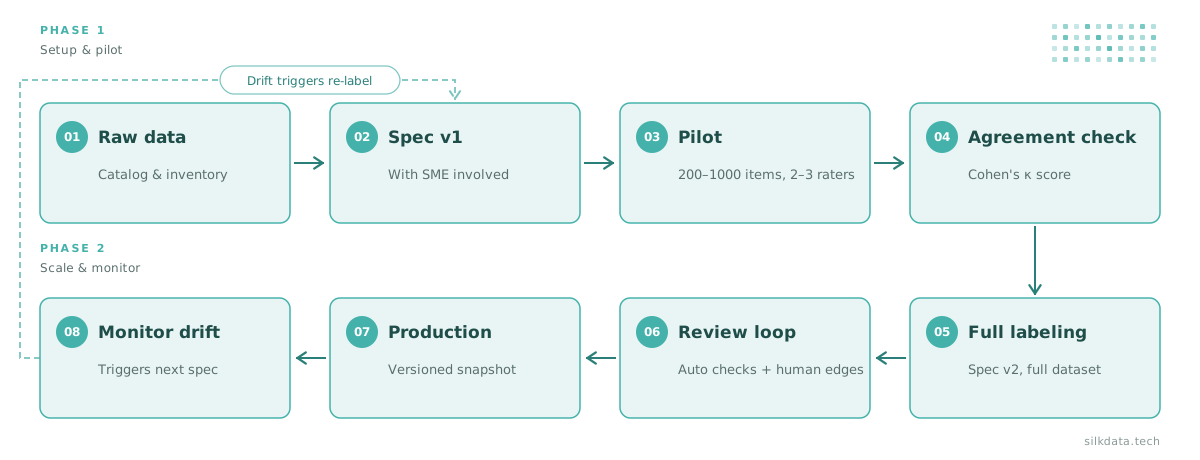
- Definieren Sie die Kennzahl vor den Labels. Wenn Sie nicht sagen können, wie „gut“ aus geschäftlicher Sicht aussieht, wird kein Label-Schema Sie retten. Wir verwenden etwa 10 % des Projekts hierauf, und es zahlt sich über den Rest hinweg aus.
- Binden Sie einen Fachexperten in das Projekt ein. Wir beginnen nicht mit dem Labeling ohne einen solchen. Ein Radiologe, ein Underwriter, ein Compliance-Beauftragter – jemand, der schwierige Fälle klären kann. Der Tierhaltungs-Datensatz, an dem wir arbeiteten, enthielt für ein Tier den Eintrag „mehrere Dutzend Tonnen“. Nur ein Fachexperte erkennt so etwas schnell.
- Führen Sie einen kleinen Piloten durch. 200–1000 Elemente, zwei bis drei Bewerter, Übereinstimmung messen. Lesen Sie die Abweichungen laut vor. Überarbeiten Sie die Spezifikation.
- Versionieren Sie die Spezifikation. Kennzeichnen Sie jeden Datensatz-Snapshot mit der Spezifikationsversion, die ihn erzeugt hat. Beim erneuten Training wissen Sie, was sich geändert hat.
- Setzen Sie Debiasing dort ein, wo es passt. Random Effects Models, Dawid-Skene, MACE – nützlich, wenn Sie mehrere Bewerter pro Element haben. Nutzlos, wenn die Spezifikation unklar ist.
- Bauen Sie eine Prüfschleife auf. Automatisierte Prüfungen erfassen Regelverstöße. Menschen bearbeiten Grenzfälle und speisen sie zurück in die Spezifikation ein.
- Überwachen Sie in der Produktion. Verfolgen Sie die Label-Verteilung und das Modellvertrauen im Zeitverlauf. Eine Drift bei einem der beiden ist Ihr Frühwarnsignal.
- Sorgen Sie für Nachvollziehbarkeit. Wer hat gelabelt, wann und gegen welche Spezifikationsversion. Verpflichtend unter der DSGVO für personenbezogene Daten und unter dem EU AI Act für Hochrisikosysteme.
Polina Volodina, die Kunden zu KI-Strategie und Machbarkeit berät, warnt Führungskräfte häufig davor, die Schritte 1 und 2 zu überspringen. Der Drang, direkt zur Modellierung überzugehen, ist stark. Die Kosten für das Überspringen der Kennzahl und des Fachexperten zeigen sich später. Ein Modell geht in Betrieb und versagt dann still bei den Fällen, die am wichtigsten sind.
Die unbequeme Wahrheit über KI-Budgets
Über Projekte in den Bereichen Finanzwesen, Gesundheitswesen, Marketing und Verlagswesen hinweg ist ein Muster konstant. Organisationen geben zu viel für die Modellauswahl und zu wenig für das Labeling aus. Die Annahme lautet, dass ein besserer Algorithmus verrauschte Daten kompensieren wird. Das wird er nicht.
Labeling ist keine Ware, die an den günstigsten Anbieter vergeben werden sollte. Ein Radiologe, der einen Scan falsch labelt, macht keinen Tippfehler. Er bringt dem Modell eine falsche Lektion bei, die sich bei jeder Inferenz wiederholen wird. In einem System, das monatlich 10.000 Scans sieht, entspricht ein konsistenter Labeling-Fehler 120.000 falschen Vorhersagen pro Jahr.
Das Gegenargument zählt ebenfalls. Nicht jedes Projekt benötigt umfangreiche Investitionen in das Labeling. Manche Probleme lassen sich mit SQL und einer Regel-Engine gut lösen. Wir sagen unseren Kunden das, wenn es zutrifft. Wenn ein Join und ein Schwellenwert das Problem lösen, wird kein Modell benötigt und kein Labeling. Unser ingenieurtechnisches Prinzip lautet, mit der einfachsten Methode zu beginnen, die funktionieren könnte. Yuri Svirid, unser CEO, formuliert es in Build-vs-Buy-Gesprächen unmissverständlich. Wenn der Geschäftswert gering ist oder die Regeln stabil sind, verursacht ML Kosten, ohne Genauigkeit hinzuzufügen. Setzen Sie das Labeling-Budget dort ein, wo das Modell tatsächlich eine Entscheidung verändert.
Über Silk Data
Die meisten unserer über 200 Projekte sind irgendwann auf ein Labeling-Problem gestoßen. Wir haben gelernt, dies von Anfang an einzuplanen. In der EdTech-Arbeit hinter Plagiarix reduzierte ein sorgfältiges Label-Design für Prüfungsabgaben die Prüfzeit für unseren Kunden APT um 90 %. In unserer siebenjährigen Verlagspartnerschaft mit Reemers haben wir ein lokales LLM über deren Archive aufgebaut. Ihre Inhalte – und die Labels, die wir darüber hinaus erzeugt haben – haben ihren Perimeter nie verlassen.
Wenn Ihr KI-Projekt stagniert, liegt der Engpass in der Regel nicht am Modell. Beginnen Sie bei den Labels. Dort setzen wir üblicherweise auch an.
Häufig gestellte Fragen
Datenlabeling weist einem Datenpunkt eine Kategorie oder ein Tag zu – zum Beispiel die Kennzeichnung einer E-Mail als Spam oder kein Spam. Datenannotation ist umfassender und fügt strukturierte Metadaten hinzu, etwa Bounding Boxes auf Bildern, Zeitstempel innerhalb von Audiodateien oder Entity-Spans in Texten. Beide dienen dem überwachten Lernen. Annotation ist in der Regel teurer pro Element, dauert länger und erfordert spezialisiertere Werkzeuge.
Eine praktische Regel aus unserer Projektökonomie: Die Datenvorbereitung – einschließlich Labeling, Bereinigung und Spezifikationsarbeit – nimmt 50–65 % des gesamten Projektaufwands ein. Für einen sechsmonatigen Aufbau entspricht das 3–4 Monaten Labeling-bezogener Arbeit, häufig verteilt auf Annotatoren, einen Fachexperten und einen Prüfer. Budgets, die weniger als 40 % für die Datenvorbereitung vorsehen, überschreiten fast immer den Rahmen, weil die Arbeit nicht verschwindet – sie verlagert sich nur auf die Fehlersuche in einem Modell, das die falsche Lektion gelernt hat.
Eine niedrige Inter-Rater-Reliabilität bringt widersprüchliche Signale in das Trainingsset ein, und das Modell lernt die Widersprüche. Sauberere, konsistentere Labels verbessern die Genauigkeit oft stärker als ein Modellwechsel. Nach unserer Erfahrung und veröffentlichten Debiasing-Arbeiten können zwei gut geführte Annotatoren die Genauigkeit von acht Annotatoren mit naiver Mittelung erreichen. Die Qualität der Richtlinien schlägt die reine Anzahl der Bewerter.
Ja, aber mit Einschränkungen. LLM-basiertes Pre-Labeling und automatisierte Regelprüfungen erfassen offensichtliche Verstöße und markieren Elemente mit geringem Vertrauen zur menschlichen Prüfung. Sie können weder eine klare schriftliche Spezifikation noch einen Fachexperten bei Grenzfällen ersetzen. Richtig eingesetzt reduzieren sie den menschlichen Aufwand bei Routineelementen um 30–60 % und ermöglichen den menschlichen Prüfern, sich auf die Fälle zu konzentrieren, die das Modell tatsächlich verändern.
Fortlaufend. Definitionen verschieben sich, Vorschriften ändern sich und Produktionsdaten unterliegen einer Drift. In unserer Projektökonomie ist das Monitoring zeitlich offen – es endet nicht mit dem Deployment. Für Systeme unter dem EU AI Act oder der DSGVO ist ein nachvollziehbares, versioniertes Labeling zudem eine Compliance-Anforderung, nicht ein Nice-to-have. Planen Sie von Tag eins an regelmäßige Neu-Labelings und Spezifikationsaktualisierungen ein.




















